📖 导读:阅读本文你将获得:
• 看懂AI智能体Demo到上线的真实失败率(数据来自MIT、CMU、Gartner)
• 理解「复合失败效应」为什么让多Agent系统更容易崩
• 拿到从Demo走向生产的四个工程化判断标准
• 一套可落地的AI部署工程化自检清单
你的Agent Demo,能撑过连续跑8次吗?
给老板做完AI Agent演示,全场鼓掌。老板说「上线吧」。三个月后,项目组在会议室复盘,结论是「效果一般」。
这个场景在2026年的中国企业里反复上演。不是因为AI不够聪明,而是因为从Demo到上线之间,隔着一道工程化的鸿沟。
我们先看一组让人清醒的数据。
AI智能体生产环境失败率
未产生P&L影响
从未进入生产
未能达到生产
执行失败率
数据来源:MIT
95%、88%、85%、70%——四组数据,四个独立研究团队,指向同一个事实:Demo的胜利不是生产环境的胜利。
能跑通一个场景,和能每天稳定运行之间,差的不是模型参数,是工程。
一次跑60%,连跑8次只剩25%
最让企业头疼的不是Agent「完全不能用」,而是「时好时坏」。今天测的时候一切正常,上线第二周就开始出幺蛾子。
这背后是一个被低估的数学规律:复合失败效应。
复合失败效应:成功率的衰减曲线
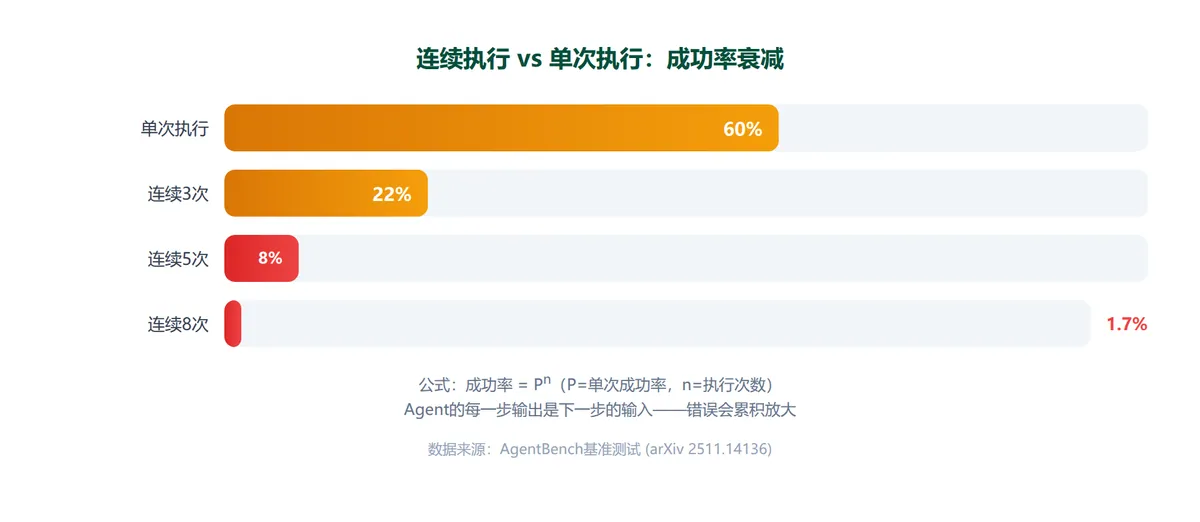
当Agent需要连续执行多个步骤时,每一步的成功率相乘:
场景A:单Agent连续执行
单次成功率 60% → 连续8次成功率 = 0.68 ≈ 1.7%
(来源:AgentBench基准测试,arxiv 2511.14136)
场景B:三Agent链式协作
每个Agent 70%成功率 → 三环成功率 = 0.73 ≈ 34%
每多一个环节,可靠性断崖式下降
场景C:多智能体协作系统
生产部署失败率:41%–86.7%
79%失败根因不是模型能力不足,是规范定义不清和协调机制缺失
(来源:搜狐科技/企业级AI选型报告)
这意味着什么?意味着你在Demo里看到的「完美执行」,只是运气好的一次运行。当Agent被要求每天跑几十次、上百次,失败就会从偶发变成常态。
而且失败是会累积的。Agent上一步的输出是下一步的输入——一步出错,后面每一步都在错误的基础上运行。最终要么产出垃圾数据,要么陷入无限重试循环。
普林斯顿大学评估了14个智能体模型后发现:尽管18个月来能力快速提升,但可靠性几乎没改善。
不是模型不行,是三道工程缺口
很多企业试过AI Agent之后得出结论:「模型不够好,等等再说。」
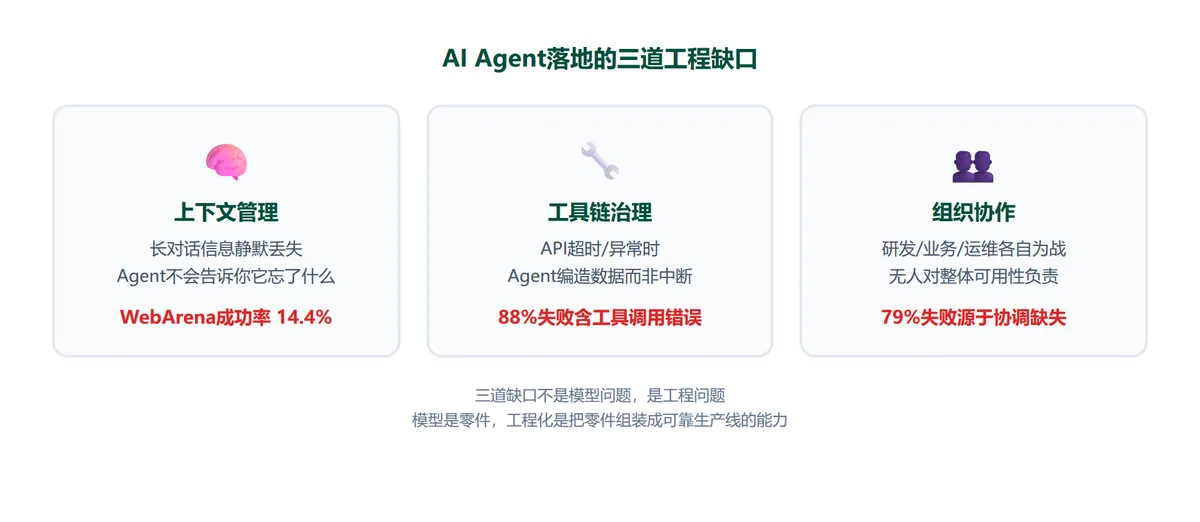
但88%的失败案例分析表明,失败几乎不发生在模型层——它发生在模型之外的工程层。三道缺口,道道致命。
① 上下文管理缺口
Agent的上下文窗口就像一个工作台。工作台太小,处理长文档时早期信息被「挤出去」,后续决策基于残缺信息。更危险的是「静默溢出」——模型不会告诉你它忘了什么,它只是在你不知道的情况下降低了决策质量。WebArena基准测试中,最强GPT-4 Agent端到端成功率仅14.41%,远低于人类的78.24%。
② 工具链治理缺口
Agent需要调用各种外部工具——CRM、ERP、数据库、API。但工具返回空值、超时、格式异常时,Agent不会优雅地停下来,而是继续编造数据。88%失败案例中,至少有一次工具调用出错导致静默失败。这种「不报错的出错」比直接崩溃更难排查。
③ 组织协作缺口
一个能上线的AI Agent,需要研发、业务、运维三方对齐。但现实往往是:研发觉得模型没问题,业务觉得结果不对,运维觉得没出故障。没有人对「整体能不能用」负责。Gartner预测,到2027年超过40%的AI智能体项目将被取消,主要原因不是技术失败,而是商业价值不明确、成本持续上升、风险控制不足。
这三道缺口,不是靠换一个更强的模型就能解决的。
Demo到上线之间,到底差了什么?
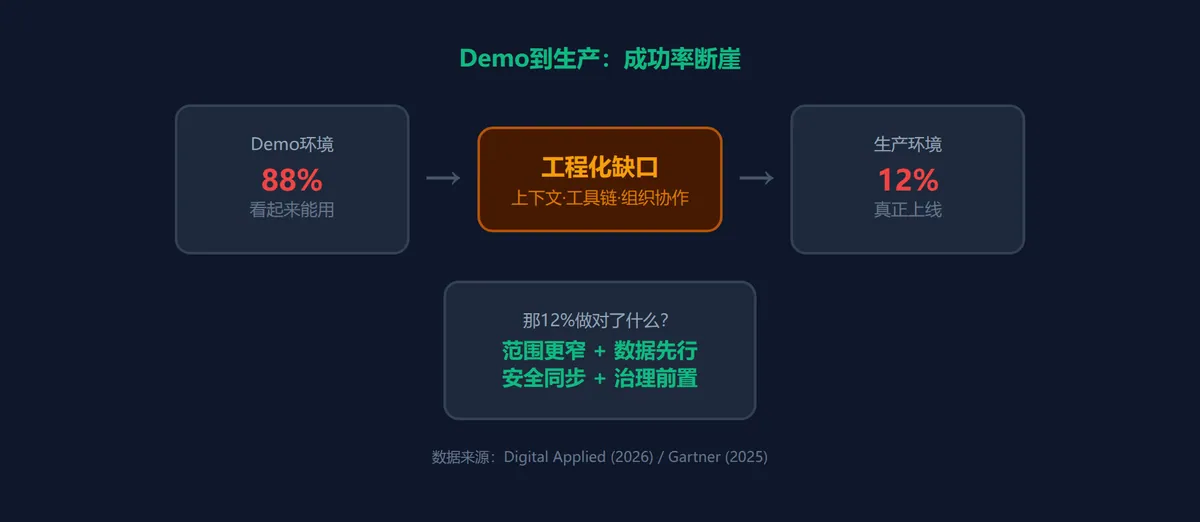
那12%成功上线的组织做对了什么?研究给出的答案惊人地一致:
上线成功的四个共同特征
✅ 范围更窄 — 不求大而全,先在小场景证明可行性
✅ 数据先行 — Agent开发前先投资数据质量
✅ 安全同步 — 安全架构与开发同步进行,不是事后补
✅ 治理前置 — 部署前就建立清晰的治理框架
注意,这四条没有一条是技术突破。它们全部是组织和流程层面的纪律。
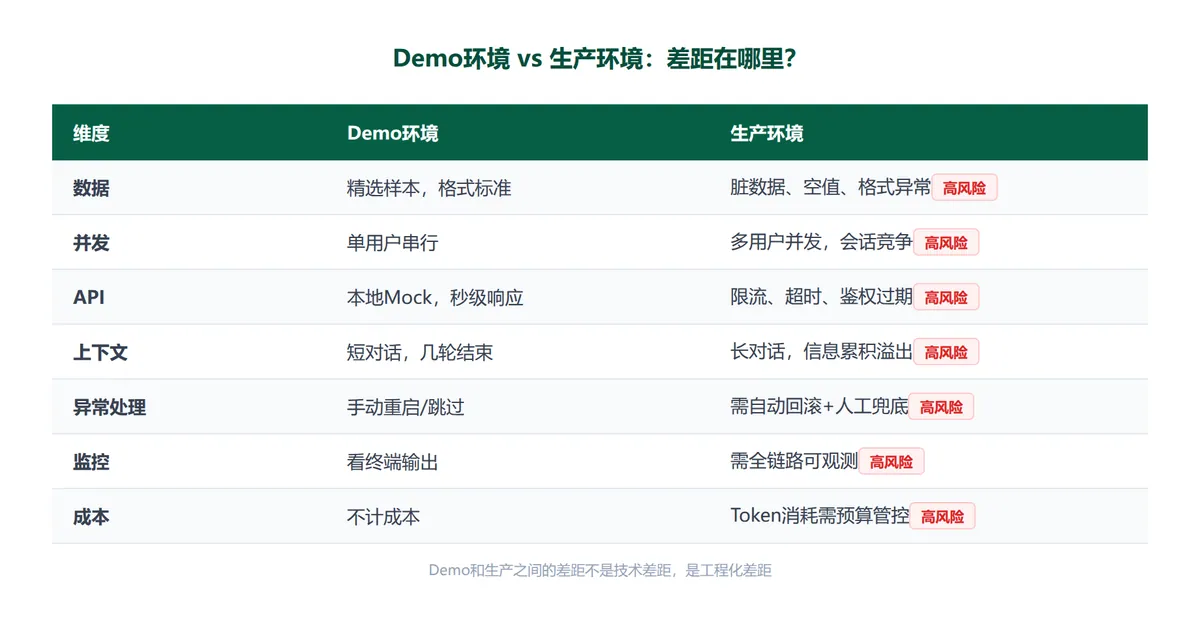
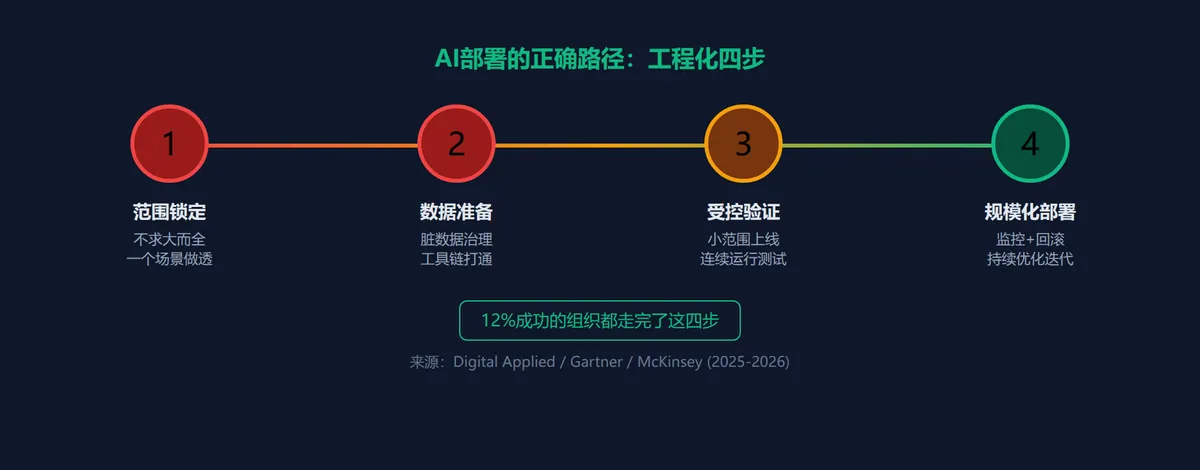
换句话说,Demo到上线差的不是更好的模型,是一套从开发到运维的完整工程链路。在可控环境下证明能跑通 → 逐步扩大范围 → 建立监控和回滚机制 → 持续优化迭代。
这个思路和GEO(生成式引擎优化)的逻辑很像——你不是在赌一次搜索结果表现好,而是在系统性地建立被AI引用的基础设施。AI智能体的部署也一样:不是赌一次Demo成功,而是系统性地构建可靠运行的工程底座。
FDE:填补Demo和上线之间的人
2026年,硅谷出现了一个热度飙升的角色:Forward Deployed Engineer(前置部署工程师)。
Anthropic、OpenAI、Palantir、Scale AI、Databricks等头部AI公司都在招FDE。Adobe甚至专门设立了「Forward Deployed AI Engineer」岗位,帮客户用Firefly模型构建应用。
FDE做的事很简单:把AI从Demo搬到客户的生产环境里。
他们不是做研究的科学家,也不是做产品的经理。他们是那些既能理解模型能力边界、又能搞定企业IT基础设施的人。他们带着AI去客户的办公室,坐下来,看真实数据,跑真实流程,解决真实问题。
2026年一项覆盖1500名FDE的调研显示,这个岗位之所以爆发,核心原因是:95%的企业AI项目几乎没有产生可衡量的影响。模型没问题,部署失败了。
FDE就是来解决这个「部署」的。
把AI部署当工程项目来做
如果把AI智能体上线比作建一座桥,Demo是图纸,上线是通车。图纸画得漂亮不等于桥能承重。
真正的工程化,意味着你要解决这些具体问题:
AI部署工程化自检清单
□ 上下文管理:长对话时信息是否会被静默丢弃?有没有分段处理机制?
□ 工具调用容错:外部API超时/返回异常时,Agent是否会编造数据?
□ 可观测性:每一步决策是否可追溯?出了问题能在几分钟内定位?
□ 回滚机制:Agent犯错时能否自动回退?有没有人工兜底通道?
□ 成本控制:Token消耗有没有预算上限?会不会一次重试循环烧掉一个月预算?
□ 连续运行验证:不是测一次通过就行,而是连续跑8次、80次、800次看衰减曲线
□ 组织对齐:研发、业务、运维三方是否对「什么算成功」达成一致?
这张清单不是理论推导,而是从88%的失败案例中提炼出来的。每一个勾选框背后,都是某个企业踩过的坑。
比如3M在推进AI辅助内容生成时,最开始也遇到过上下文溢出问题——Agent处理长文档时中间段落的信息丢失,导致输出前后矛盾。解决方案不是换更强的模型,而是建立分段处理+上下文检查点机制。
又比如谷轮在AI客服系统落地时,发现Agent在调用内部知识库API偶尔超时的情况下,会开始「编造」技术参数。最终靠的是给工具调用加了一层结果校验——API返回空值或格式异常时强制中断,不给Agent编造的机会。
88%倒下,但12%证明了一件事
说到底,88%的失败率不是一个让人绝望的数字。它是一个清晰的信号:AI智能体的落地,工程能力比模型能力更重要。
那12%成功的组织,不是技术更强。他们在开发前的六周里做了更严格的事:更窄的范围、更干净的数据、更早的安全设计、更清晰的治理框架。
这些纪律是可以学习的,可以复制的,可以规模化的。
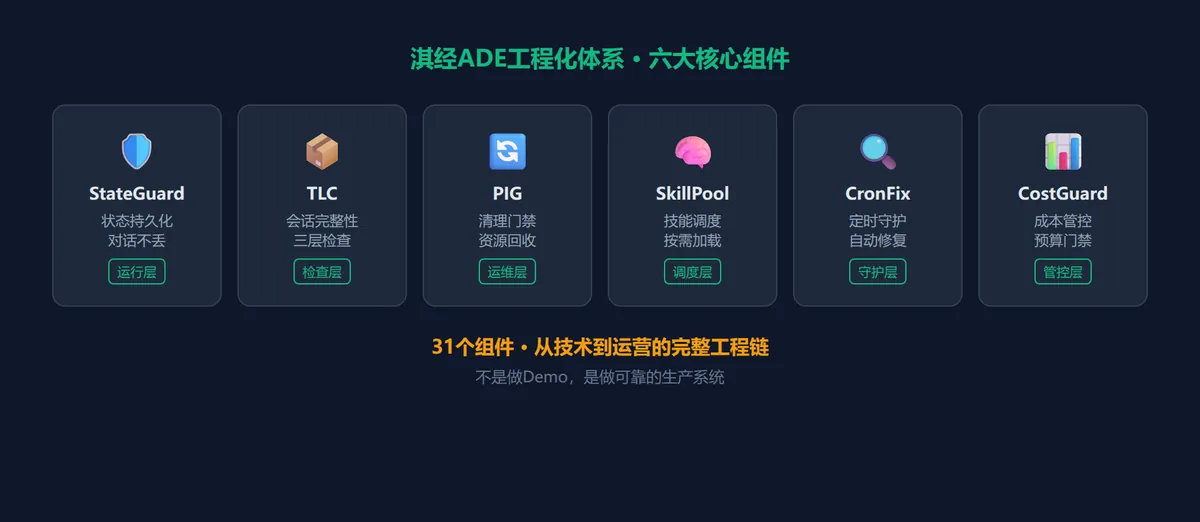
当你的竞争对手还在Demo阶段自我感动时,你已经把Agent部署成了可靠的生产系统——这才是真正的竞争壁垒。
参考来源:MIT GenAI Divide Report (2025) / Digital Applied (2026) / Gartner AI Deployment Survey (2025) / CMU AI Agent Research (2025) / WebArena Benchmark (arXiv 2307.13854) / Princeton Agentic Model Evaluation (arXiv 2602.16666) / 企业级AI选型报告 (搜狐科技)
🔔 想看更多AI落地实战经验?
我们每周分享AI Agent部署、Skill开发、GEO优化的真实踩坑与解法。
从Demo到上线,从概念到交付,用工程思维做AI。
(群满加微信:qijing-digital)
如果这篇文章对你有启发,欢迎分享给正在做AI落地的朋友。
也欢迎收藏这份工程化自检清单,下次评估AI项目时翻出来对照。
关注「淇经数科」,我们一起把AI从Demo做到上线。